本文為 OpenAI、ElevenLabs、Google Cloud 官方文件與定價頁的整理比較,不是實測評測。文中每一項規則都附原始出處與本次查證日期(2026-08-01)。
先講結論
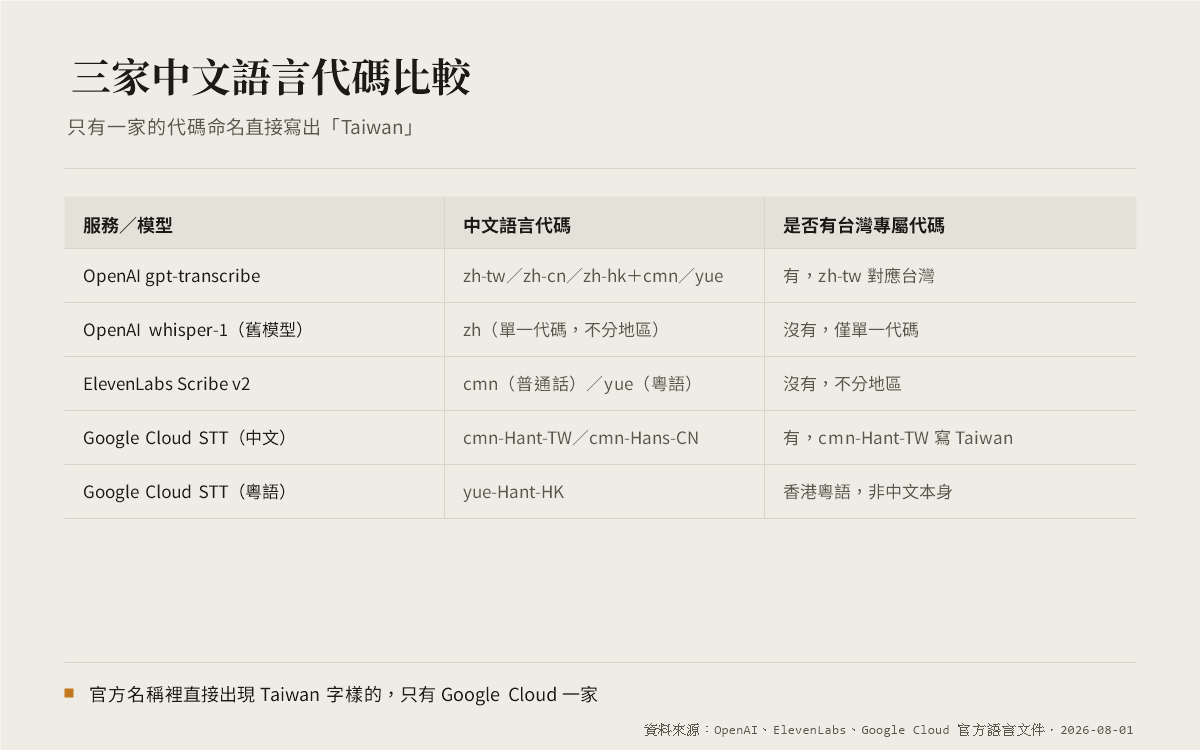
- 三家都說支援「中文」,但只有 Google Cloud 把「台灣」寫進語言代碼本身。Google 的
cmn-Hant-TW官方名稱直接寫「Chinese, Mandarin (Traditional, Taiwan)」;OpenAI 的新模型 gpt-transcribe 有zh-tw這個區域提示碼;ElevenLabs 只有cmn(普通話)與yue(粵語)兩個語言代碼,沒有任何地區區分。 - OpenAI 自己的舊模型 whisper-1 也不支援 zh-tw。只有新的 gpt-transcribe 模型能吃 languages 陣列與區域代碼,whisper-1 仍然只能給單一的 language 提示,官方文件寫的是「existing models that accept one language hint use language instead of languages」。
- 中文準確度的官方數字,只有 ElevenLabs 公開查得到。官方文件把 Mandarin(cmn)與 Cantonese(yue)都列在「>5% to ≤10% WER」這個分級,不是最高的 ≤5% 分級;但同一個網站的行銷文案又寫「Over 98% transcription accuracy」,兩個數字看起來的等級不完全一致。OpenAI 與 Google 的文件都沒有公開個別語言的準確度數字。
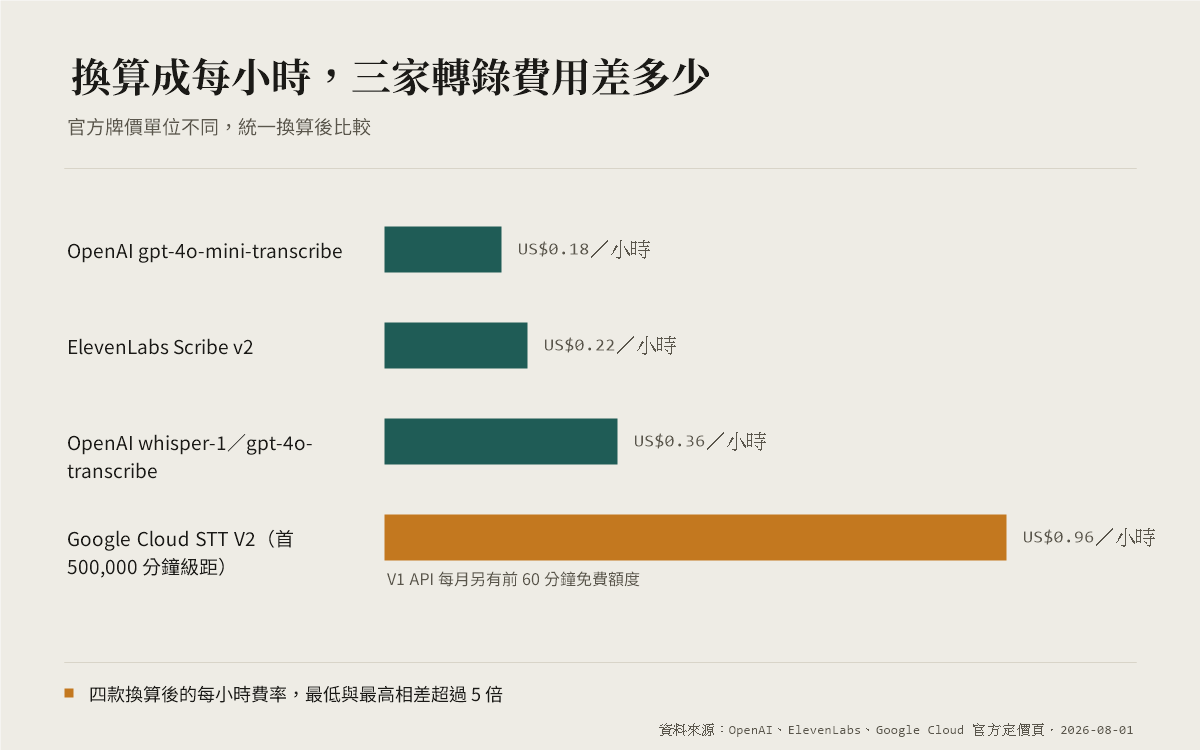
- 換算成每小時費用,三家差距超過 5 倍。OpenAI gpt-4o-mini-transcribe 約 US$0.18/小時最便宜,ElevenLabs Scribe v2 是 US$0.22/小時,OpenAI 的 whisper-1/gpt-4o-transcribe 是 US$0.36/小時,Google Cloud STT V2 官方定價換算約 US$0.96/小時。
- 台灣可用性查得到的部分:OpenAI 官方支援地區清單明確列出 Taiwan;ElevenLabs 服務條款的地區限制條款沒有把台灣列進去。但三家是否提供繁體中文版服務條款、台灣信用卡實際授權情況,本次查不到官方一級來源,因此不給結論。
三家怎麼定義「中文」:官方語言代碼一次攤開比較
中文圈常見的字幕工具推薦文,多半只會寫「支援中文」三個字就帶過,但「中文」在官方文件裡從來不是一個代碼,而是好幾個不同的代碼,差別就在於有沒有把台灣、香港、中國大陸分開處理。
OpenAI 目前推薦的轉錄模型是 gpt-transcribe,官方文件在「Supported languages」段落寫的是:支援 ISO 639-1 代碼(如 en)、部分 ISO 639-3 代碼(如 yue、cmn),以及「Regional zh locale codes, such as zh-cn, zh-tw, and zh-hk」,也就是區域化的 zh 代碼。這些代碼是透過 languages 參數傳入,做為模型判斷輸入語言的提示。舊一代的 whisper-1 則沒有這個機制,官方文件寫「existing models that accept one language hint use language instead of languages」,只能傳單一語言代碼,且官方另外要求「for whisper-1, consult the Whisper language list」,代表舊模型的語言清單跟新模型不是同一份。
ElevenLabs 的 Scribe v2 文件在語言支援段落列出的是 ISO 639-3 風格的代碼:Mandarin 對應 cmn(部分版本文件標示為 zho),Cantonese 對應 yue。整份清單裡沒有出現任何帶地區後綴的中文代碼,普通話與粵語各自是獨立語言,但普通話底下不分繁體、簡體,也不分台灣、中國大陸。
Google Cloud Speech-to-Text 的語言清單是三家裡分得最細的。官方頁面把中文拆成三個獨立的 BCP-47 代碼:cmn-Hans-CN(Chinese, Simplified, China)、cmn-Hant-TW(Chinese, Mandarin, Traditional, Taiwan)、yue-Hant-HK(Chinese, Cantonese, Traditional, Hong Kong)。三個代碼的官方名稱裡都直接寫出了地區名稱,Taiwan 這個字就出現在代碼的正式命名裡,不是額外註記。
官方公布的中文準確度數字,其實只有一家攤開講
「哪個工具中文辨識比較準」是這題最多人想問、但也最難誠實回答的部分。本站的方法論是只看官方公開發布的數字,不做主觀排名,而三家在這件事上公開的程度差很多。
OpenAI 的文件在準確度上寫得很保守,只提到 whisper-1「supports 98 languages, but accuracy varies by language」,沒有列出中文或任何語言的具體數字。gpt-transcribe 的文件同樣沒有公開逐語言的準確度數據。
Google Cloud 的語言支援頁面列出各模型(Chirp、Chirp 2、Chirp 3 等)支援的語言與功能,但同樣沒有公開個別語言的錯誤率或準確度百分比。
只有 ElevenLabs 把準確度數字攤開公布。官方文件把 Scribe v2 支援的語言依字詞錯誤率(WER)分成四個分級,最高等級是「≤5% WER」,涵蓋約 35 種語言(如日文、西班牙文、德文等);Mandarin(cmn)與 Cantonese(yue)都被列在下一個等級「>5% to ≤10% WER」,跟印地文、韓文所在的更低等級不同層。但同一個網站在產品行銷頁的標語寫的是「Over 98% transcription accuracy」,這是一個整體性的宣傳數字,跟語言分級表裡中文所在的 5–10% WER 區間,字面上看起來不是同一個標準下的數字。本站不替官方解讀這個落差的原因,只把兩處官方文字都列出來,讓讀者自己判斷要採信哪一個情境下的數字。
換算成每小時,三家的轉錄費用差多少
三家的計價單位不一樣,OpenAI 用「每分鐘」,ElevenLabs 用「每小時」,Google 也是「每分鐘」,直接看牌價不容易比較,換算成統一的「每小時」比較好對照:
OpenAI 的 whisper-1 與 gpt-4o-transcribe 官方牌價都是 US$0.006/分鐘,換算約 US$0.36/小時;gpt-4o-mini-transcribe 是 US$0.003/分鐘,換算約 US$0.18/小時,是三家裡最便宜的選項,官方定價頁沒有列出語音轉文字的固定月度免費額度。
ElevenLabs Scribe v2 直接以小時計價,官方頁面寫的是 US$0.22/小時;Free/隨用隨付方案的 Scribe 月度包含額度是 0 小時,代表沒有訂閱方案時是純粹的隨用隨付,不需要先綁月費方案。
Google Cloud Speech-to-Text 的計價分 V1 與 V2 兩套 API。V1 API 每月前 60 分鐘免費,超過後未啟用資料記錄功能是 US$0.024/分鐘(換算約 US$1.44/小時),啟用資料記錄功能是 US$0.016/分鐘。V2 API 則是分級計價,每月 0 到 500,000 分鐘這個級距是 US$0.016/分鐘,換算約 US$0.96/小時,用量越大單價越低。
舊模型不懂台灣:連 OpenAI 自己都不是每個模型都支援 zh-tw
這是三家比較裡最容易被忽略的細節:同一家公司的不同模型,語言代碼支援程度可能不一樣。
OpenAI 官方文件明確把 gpt-transcribe 定位為「the recommended model for transcribing recorded speech in its original language」,也是唯一支援 languages 陣列與 zh-tw/zh-cn/zh-hk 區域提示的模型。whisper-1 則被保留給需要字詞或段落時間戳記、字幕製作、或翻譯成英文的情境使用,官方寫的是「Use whisper-1 when you need word or segment timestamps」。但 whisper-1 的語言提示機制是舊的單一 language 參數,不吃區域化的 zh-tw 代碼。也就是說,如果選字幕工具時只看「這家背後用不用 Whisper」,卻沒注意是新版 gpt-transcribe 還是舊版 whisper-1,實際拿到的語言辨識能力可能不一樣,這個差異目前中文內容幾乎沒人寫。
翻譯功能也有類似的模型限制:OpenAI 官方文件寫明 /v1/audio/translations 端點只支援 whisper-1,且「This endpoint supports translation into English only」,也就是只能把其他語言翻成英文,不能反過來把中文翻成其他語言。
什麼情境該選哪一家
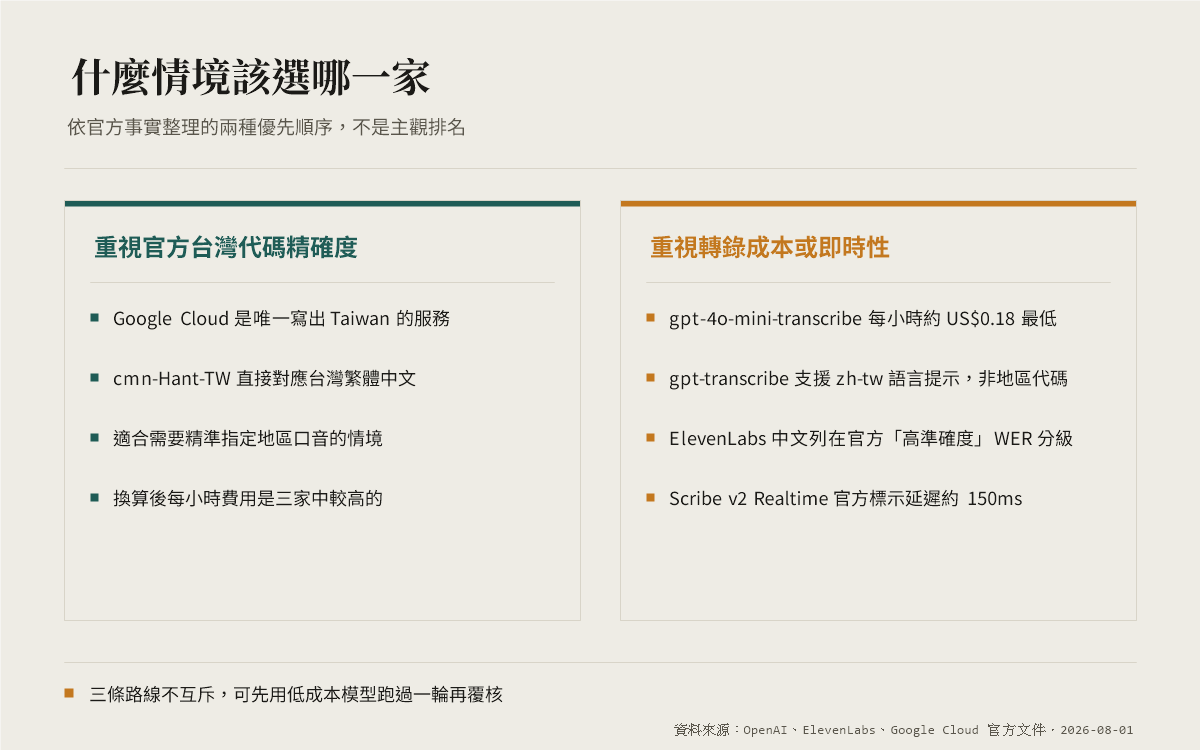
把前面三段的官方事實放在一起,可以整理出兩種不同的優先順序,分別對應不同的需求:
如果你需要在代碼層級明確指定「台灣」而不是籠統的「中文」,例如處理台灣口音的訪談逐字稿、或需要在多語系統裡精確區分兩岸三地的中文變體,Google Cloud STT 是三家裡唯一在語言代碼命名上直接寫出 Taiwan 的服務,但換算下來的標準費率也是三家最高。如果你在意的是低成本、大量轉錄,OpenAI 的 gpt-4o-mini-transcribe 每小時約 US$0.18,是三家最低;它的上位模型 gpt-transcribe 額外支援 zh-tw 語言提示,但這個提示是「預期輸入語言」的線索,不等同於 Google 那種代碼本身就綁定地區的做法。如果你需要即時字幕(低延遲)或說話人分離這類進階功能,ElevenLabs 的 Scribe v2 Realtime 官方標示延遲約 150ms,且中文被列在官方 WER 分級的「高準確度」級距,價格則落在三家中段。
這三條路線沒有互斥,實務上常見的做法是先用便宜的模型跑過一輪,遇到台灣特定口音或專有名詞辨識不準時,再針對那些片段換用有明確地區代碼的服務覆核。
台灣使用者要注意的幾件事
在地化這部分,誠實地說,官方一級來源能確認的內容有限,能查到多少就寫多少。
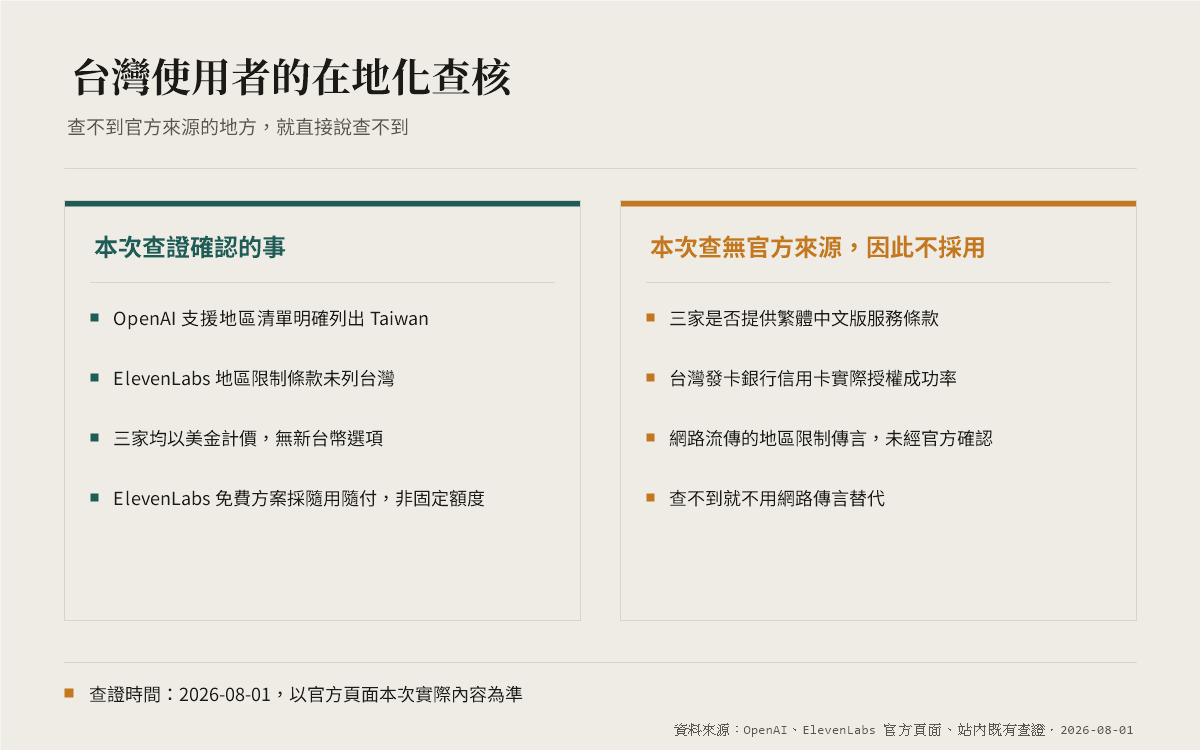
本次查證確認的事:OpenAI 官方的「Supported countries」清單裡明確列出「Taiwan」;ElevenLabs 服務條款裡的地區限制條款,列出的是受美國經濟制裁或貿易禁運影響的國家(白俄羅斯、古巴、伊朗、北韓、俄羅斯、敘利亞及烏克蘭被併吞地區),台灣不在這份清單裡。三家的官方定價頁都以美元計價,沒有新台幣選項。Google Cloud 帳號的實際開通步驟與免費額度規則,本站先前查證 Google Cloud TTS 免費額度時已經詳細記錄過,Speech-to-Text 用的是同一套 Google Cloud 帳務系統(見下方內部連結)。
本次查證沒有官方來源可以確認的事:三家是否提供繁體中文版的服務條款;台灣發卡銀行的信用卡在訂閱這三項服務時實際授權成功率如何。網路上關於「某些服務台灣卡容易被拒」的說法不少,但來源多半是非官方的第三方部落格,不符合本站的來源分級標準,這篇不採用,也不當成結論的一部分。
常見問題
Q:這三家哪一家的中文辨識最準?
本站不做主觀的準確度排名。官方公開發布逐語言準確度數字的只有 ElevenLabs,把 Mandarin 與 Cantonese 列在「>5% to ≤10% WER」分級;OpenAI 與 Google 的官方文件都沒有公開個別語言的準確度百分比,因此無法三家並列比較同一個標準下的數字。
Q:OpenAI 的 Whisper 是不是已經不推薦用了?
官方文件目前把 gpt-transcribe 列為「the recommended model for transcribing recorded speech in its original language」,whisper-1 則保留給需要字詞時間戳記、字幕製作、或翻譯成英文的情境。兩個模型都還在服務中,差別在於支援的功能與語言代碼機制不同。
Q:Google Cloud 的 cmn-Hant-TW 是不是代表辨識結果一定用繁體字輸出?
本次查證的官方語言清單頁面只確認這個代碼的官方名稱是「Chinese, Mandarin (Traditional, Taiwan)」,屬於可選用的語言代碼之一;頁面沒有進一步說明實際輸出字型與腔調辨識的細節,這部分建議直接以官方文件的最新版本與實際回傳結果為準。
Q:三家服務台灣可以直接刷卡訂閱嗎?
OpenAI 官方支援地區清單有列出台灣,ElevenLabs 服務條款的地區限制清單也沒有把台灣列入受限名單。但實際刷卡是否成功,屬於個別銀行的授權判斷,本次查證找不到官方一級來源可以給出保證,建議以自己銀行當下的授權結果為準。
Q:ElevenLabs 免費方案可以直接用 Scribe 轉錄嗎?
官方定價頁列出的 Free/隨用隨付方案,Scribe v2 與 Scribe v2 Realtime 的月度包含額度都是 0 小時,代表沒有固定的免費額度,但可以用隨用隨付的方式直接付費使用,不需要先訂閱月費方案。
結論
「支援中文」這四個字在三家官方文件裡,其實對應到完全不同的技術實作:Google Cloud 把台灣寫進語言代碼本身,OpenAI 的新模型有區域提示但舊模型沒有,ElevenLabs 則完全不分地區。選字幕工具前,先確認自己要處理的是哪一種「中文」情境:需要代碼層級的地區精確度,還是單純要把聲音轉成文字,會比只看「準不準」這種主觀問題更容易做決定。
價格上,三家換算後的每小時費用差距超過 5 倍,而且同一家公司內不同模型的價格與語言支援能力也不一樣,訂閱前建議直接對照官方定價頁確認用的是哪一個模型版本。
如果你正在比較其他 AI 語音工具的免費額度與商用條件,可以參考本站另外兩篇查證:〈Google Cloud TTS 免費額度怎麼開通?官方文件寫的跟大家轉述的不一樣〉整理了 Google Cloud 帳號開通與免費額度的實際規則;〈ElevenLabs 免費版可以商用嗎?答案是不行,但真正會害到你的是另外三件事〉查證了 ElevenLabs 免費方案的商用限制,方法論跟這篇一致。
作者:德|卡關筆記編輯|發布日:2026-08-01|更新日:2026-08-01
參考來源
| 內容 | 原始發布者 | 分級 | 查閱日 |
|---|---|---|---|
| gpt-transcribe 支援語言代碼(ISO 639-1/639-3、zh-cn/zh-tw/zh-hk 區域碼)、whisper-1 僅支援單一 language 參數 | OpenAI — File transcription | 🟢 官方 | 2026-08-01 |
| whisper-1、gpt-4o-transcribe、gpt-4o-mini-transcribe 每分鐘計價 | OpenAI — API Pricing | 🟢 官方 | 2026-08-01 |
| OpenAI API 支援地區清單,Taiwan 列於其中 | OpenAI — Supported countries | 🟢 官方 | 2026-08-01 |
| ElevenLabs Scribe v2 語言代碼(cmn、yue)、WER 準確度四級分類,Mandarin/Cantonese 列於 >5%–≤10% 級 | ElevenLabs Documentation — Transcription | 🟢 官方 | 2026-08-01 |
| Scribe v2/Realtime 每小時計價、「Over 98% transcription accuracy」標語、Free/隨用隨付方案額度 0 小時 | ElevenLabs — API Pricing | 🟢 官方 | 2026-08-01 |
| ElevenLabs 服務條款地區限制條款,列出受制裁地區清單,未列台灣 | ElevenLabs — Terms of Use | 🟢 官方 | 2026-08-01 |
| Google Cloud Speech-to-Text 中文相關語言代碼(cmn-Hans-CN、cmn-Hant-TW、yue-Hant-HK)與官方名稱 | Google Cloud — Speech-to-Text 支援的語言 | 🟢 官方 | 2026-08-01 |
| Google Cloud Speech-to-Text V1/V2 API 計價,含每月前 60 分鐘免費額度 | Google Cloud — Speech-to-Text 定價 | 🟢 官方 | 2026-08-01 |