先講結論
- 一個被廣泛引用的「AI 內容流量掉 71%」數字,回溯後源頭是一家賣 SEO 代寫服務的公司發的付費新聞稿,而且同一份文件裡的相關性數據是 0.011,跟標題自相矛盾。
- 「78% 企業已導入 AI」被當成最新數據引用,但麥肯錫 2025 年 11 月報告的實際數字是 88%,78% 是前一年的。
- 第三個錯誤是我自己寫的:我斷言 WordPress 語言設定會影響 Google 判定語系,查完官方文件才發現 Google 明講不看
lang屬性。 - 三個案例的共同點:看起來都有數據、都有來源、都有連結。
- 文末是三步追溯法,每個數字花你 90 秒。
我在建立這個網站的過程中,反覆遇到同一件事:AI 給我的資料,要嘛過時、要嘛不準。
一開始我以為這是模型能力的問題。用久了才發現不是。最強的模型加上即時搜尋,在沒有流程約束的情況下,照樣會引用垃圾來源。 因為它面對的網路,本來就充滿了看起來很像研究的東西。
以下三個案例都發生在這個專案裡,我一個一個回溯過。第三個是我自己犯的。
案例一:一個 71% 的數字,源頭是賣代寫服務的公司
事情是這樣開始的:我在討論 AI 內容的風險時,看到一個說法——「Google 2026 年 3 月核心更新後,大量產出的 AI 內容流量掉了 71%」。
這個數字很有說服力。它具體、有出處、講的是最近發生的事。
我回去追源頭,找到了。是一份發在 openpr.com 上的新聞稿,發布者叫 JetDigitalPro。
三件事讓這份資料當場出局:
第一,它的標題自己在賣東西。 完整標題是「Google March 2026 Core Update: New Data Highlights 71% Traffic Drop and 22% Gains, Revealing the Role of Best SEO Content Writing Services」。翻成白話:一家賣 SEO 代寫的公司,發布了一份「證明沒有專業代寫會掉流量」的研究。
第二,它不是原始研究。 這份文件是把 Ahrefs、Semrush、Originality.ai、Backlinko 等九家來源的數據彙整起來的二手綜合。它自己沒有跑任何調查。
第三,它跟自己打架。 同一份文件裡寫著:AI 使用與排名懲罰的相關性是 0.011,近乎為零。
所以這份資料的標題說「AI 內容掉 71%」,內文說「AI 用不用跟被懲罰幾乎無關」。兩句話放在同一頁上。
而它被引用的時候,只有 71% 那一句被帶走了。
案例二:78% 還是 88%?
第二個案例更常見,因為它不涉及任何造假。
「78% 的企業已在至少一項業務中導入 AI」——這句話我看到過很多次,出處都寫麥肯錫。數字沒錯,來源也是真的。
問題在年份。
麥肯錫 2025 年 11 月發布的《The state of AI》報告寫的是:88% 的組織回報在至少一項業務職能中常態使用 AI,而前一年是 78%。這份調查在 2025 年 6 月 25 日到 7 月 29 日進行,涵蓋 105 個國家、1,993 位受訪者。
所以 78% 是真的,只是它是舊的。引用者看的是報導,沒有回去看報告本身。
這種錯誤最難抓,因為每一個環節看起來都合規:有具體數字、有知名機構、有人在引用。缺的只是「回去看一眼原始報告的發布日期」這個動作。
案例三:這次寫錯的是我
前兩個是別人的問題。這個是我的。
我在整理這個網站的建站紀錄時,寫下一條結論:WordPress 的站台語言設定成簡體中文,會影響 Google 對網站語系與地區的判定。
聽起來很合理。語言設定嘛,當然影響語言判定。
然後我去查了 Google Search Central 的官方文件,看到這句:
「We don't use any code-level language information such as
langattributes, or the URL.」
Google 判定頁面語言,只看可見內容。程式碼層級的語言宣告,它完全不看。
我寫的那句是錯的。
正確的機制其實是繞了一圈的:語言設定本身 Google 不看,但它會讓佈景主題和外掛把簡體字串輸出到頁面的可見內容裡,而可見內容正是 Google 唯一會參考的東西。結論一樣(該修),但理由完全不同。
我把這件事寫出來,是因為它證明了一件比前兩個案例更重要的事:這個錯誤不是 AI 幻覺,是一個聽起來太合理、所以沒人想去查的推論。 我當下沒有任何懷疑的感覺。
會抓到,純粹是因為流程規定每個結論都要回查一級來源。靠的不是判斷力,是流程。
為什麼最強的模型也會引用垃圾
把三個案例放在一起看,共同點很清楚:它們都通過了「看起來可信」這一關。
有具體數字、有機構名稱、有連結可以點。而 AI 在評估來源時,能看到的就是這些訊號。它看不到的是:
- 這個發布者有沒有在賣跟結論相關的東西
- 這份「研究」是原始調查還是彙整別人的
- 這個數字是不是已經有更新的版本
- 標題和內文有沒有在講不同的事
這四件事全都需要主動去查第二層,而不是評估眼前這一頁的品質。模型預設不會做這個動作,除非你要求它做。
這就是為什麼我在這個網站的規範裡,把「查證」寫成一套關卡制流程,而不是一句「請注意資料正確性」。願望不會被執行,動作才會。
三步追溯法:一個數字 90 秒
這是我實際在用的流程。對文章裡的每一個數字執行,不是抽查。
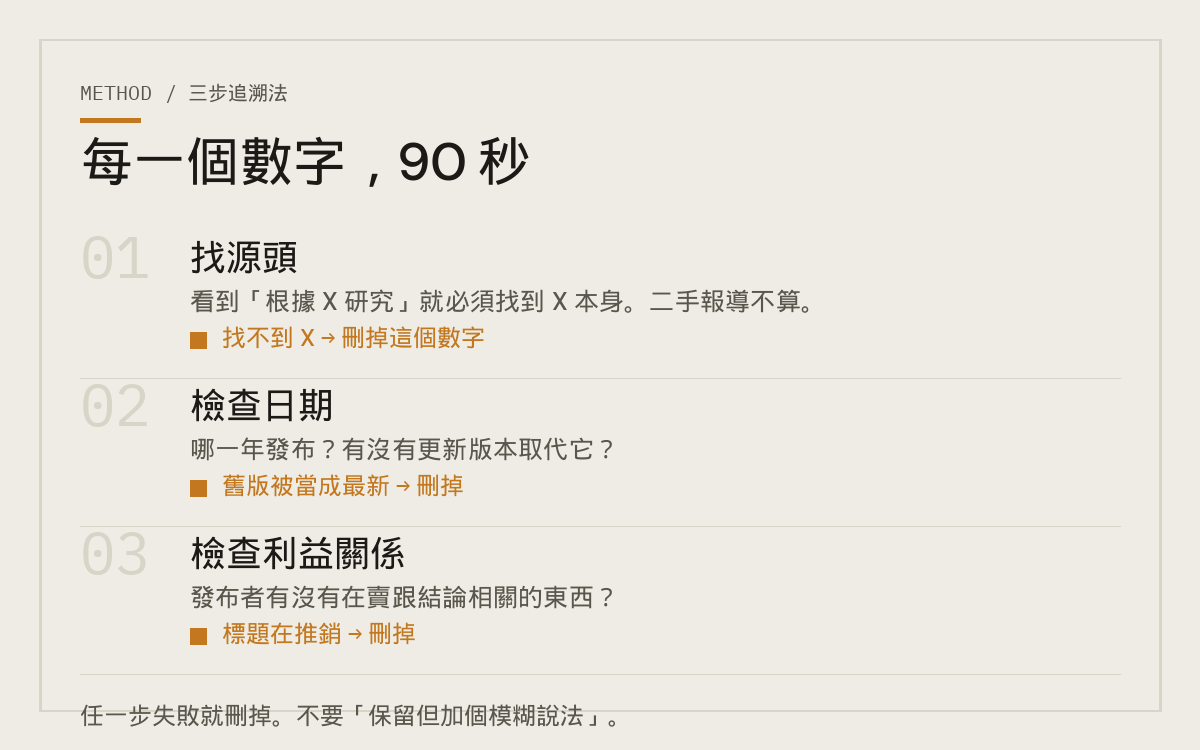
第一步:找源頭(30 秒)看到「根據 X 研究指出」,就必須找到 X 本身。二手報導不算,要摸到原始報告、論文或官方頁面。找不到 X?這個數字不能用。
第二步:檢查日期(30 秒)這個數字是哪一年發布的?有沒有更新版本?案例二就死在這一步。年度報告尤其危險,因為舊版通常還掛在網路上,而且被引用得更多。
第三步:檢查利益關係(30 秒)發布這份數據的人,有沒有在賣跟結論相關的東西?案例一就死在這一步,而且死得很明顯——標題裡就寫著他們在賣什麼。
任一步失敗,就刪掉那個數字。 不要「保留但加個模糊說法」,那只是把責任轉嫁給讀者。
這幾種來源,直接不要碰
節省時間的做法是在第一步之前就篩掉一批。符合以下任一條,我直接丟棄不看:
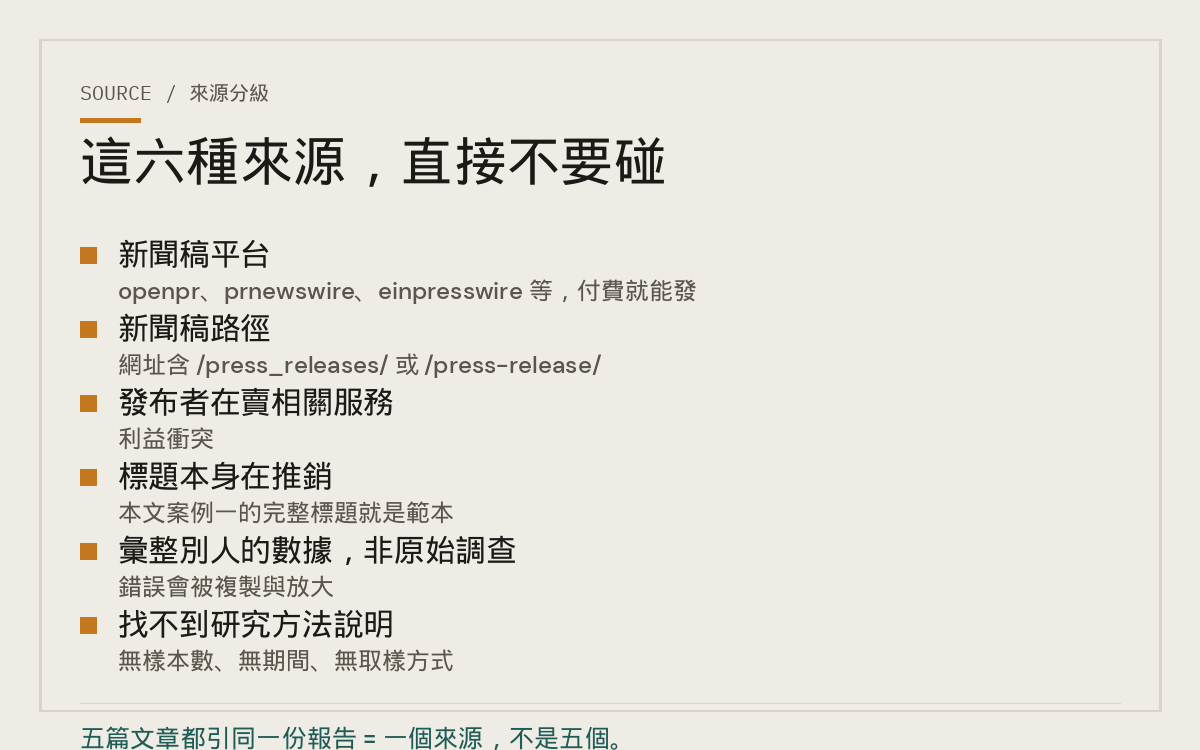
| 特徵 | 為什麼 |
|---|---|
| 網址是 openpr、prnewswire、einpresswire 等新聞稿平台 | 付費就能發,沒有編輯審查 |
網址路徑含 /press_releases/、/press-release/ | 同上 |
| 發布者自己在賣跟結論相關的服務 | 利益衝突 |
| 標題本身就在推銷 | 案例一的完整標題就是範本 |
| 「研究」是彙整別人的數據,不是原始調查 | 錯誤會被複製與放大 |
| 找不到研究方法說明(樣本數、期間、取樣方式) | 無法評估可信度 |
還有一個最多人搞錯的地方:五篇文章都引用同一份麥肯錫報告,那是一個來源,不是五個。
獨立來源指的是不同的原始研究單位、不同的資料蒐集行為。同一份報告被轉述五次,不會因此變得更可信。
所以該怎麼用 AI 查資料
還是要用。這三個案例裡,有兩個是 AI 幫我找到原始出處的。它在「搜尋與整理」這一段的效率無可取代。
要改的是把它擺在流程的哪個位置。
AI 負責找、你負責驗。 而「驗」這個動作要寫成具體的步驟,不能寫成一句「請確保資料正確」。前者會被執行,後者只會讓 AI 附一個連結交差。
案例三是最好的證明:寫錯的是 AI,抓到的是流程。
FAQ
Q:怎麼快速判斷一個網址是不是新聞稿平台?看網域名稱與路徑。openpr.com、prnewswire.com、einpresswire.com、financialcontent.com 這幾個是常見的付費發布平台,路徑含 /press_releases/ 或 /press-release/ 也是明顯訊號。這類平台不做編輯審查,付費就能刊登,所以內容的可信度等同於發布者本身的可信度。
Q:AI 給的連結點得開,是不是就代表數據可信?不是。連結能打開只證明那一頁存在,不證明那一頁是原始出處。本文案例一的連結完全正常,內容也讀得通,問題出在發布者身分與資料性質。要看的是「這一頁是不是原始發布者」,不是「這一頁能不能開」。
Q:年度報告的數字要怎麼確認是最新的?直接到發布機構的官方頁面找該系列報告的最新一期,比對發布月份。像麥肯錫《The state of AI》這類年度調查,舊版通常還留在網路上而且被引用得更多,光看搜尋結果排序會誤判。
Q:如果一個數字查不到原始出處,但我覺得它應該是對的,可以用嗎?不建議。可行的替代做法是改成明確標註不確定性的寫法,例如「這是業界普遍的觀察,但我沒有找到可驗證的原始數據」。誠實標註不確定,比假裝確定可信得多,對讀者與搜尋引擎都是。
Q:三步追溯法每篇文章要花多少時間?一個數字約 90 秒。一篇有十個數字的文章大約 15 分鐘。比較省時的做法是在寫作之前就建好來源清單,而不是寫完再回頭補查,後者通常會演變成為既有句子找背書。
延伸閱讀
- 案例三發生在這篇的另一個角度裡:AI 幫你建好的網站,其實有 11 個地方沒完成
- 同一套驗證邏輯用在修網站上:我把 AI 建的網站從 69 分修到 87 分
參考來源
- McKinsey & Company,《The state of AI in 2025: Agents, innovation, and transformation》,2025 年 11 月(🟢 一級)
https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-state-of-ai
- Google Search Central,〈Managing multi-regional and multilingual sites〉(🟢 一級,獨立來源)
https://developers.google.com/search/docs/specialty/international/managing-multi-regional-sites
關於案例一的來源處理:該新聞稿為 🔴 級來源,依本站規範不予引用、不提供連結。文中以「分析對象」而非「證據來源」的身分描述其內容,發布平台與發布者名稱據實列出以便讀者自行識別同類型內容。